La cantidad de casos la decide el riesgo
Generar casos dejó de ser caro, así que el límite lo pone el riesgo. Impacto por probabilidad, qué técnica para qué, y datos que discriminan.
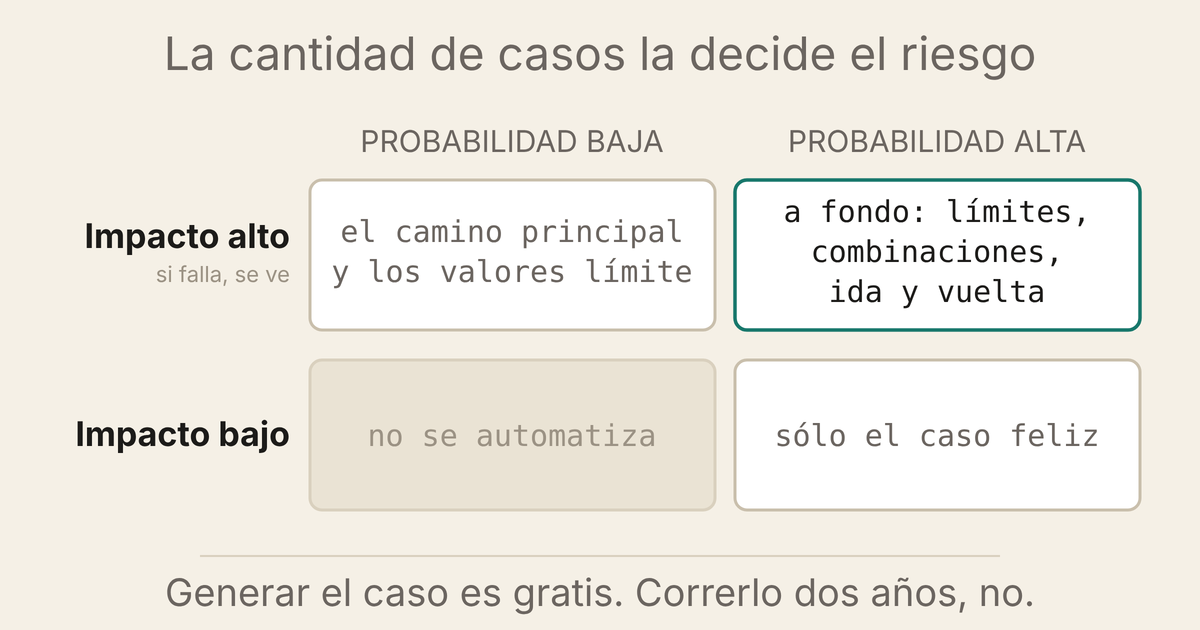
Cuando escribir un test costaba una hora, la cantidad se limitaba sola: no me daba el día. Ese límite se fue. Hoy pido cien casos y los tengo. Y un caso de más no es neutro — es una corrida más larga, un rojo más que revisar, una cosa más que mantener cuando la pantalla cambie.
Así que el límite tiene que venir de otro lado. Lo pongo antes de generar, y lo pone el riesgo.
Lo que sigue es cómo decido cuántos casos entran y de qué profundidad, antes de que ningún agente escriba una línea.
Primero el riesgo, después la técnica
Cada funcionalidad entra por una matriz de dos ejes: qué tan grave es que falle y qué tan probable es que falle. El cruce no dice sí o no: dice cuánto.
| Probabilidad baja | Probabilidad alta | |
|---|---|---|
| Impacto alto | el camino principal y los valores límite | a fondo: límites, combinaciones, estados de ida y de vuelta |
| Impacto bajo | no se automatiza | un caso feliz y nada más |
Qué cae en impacto alto no es universal. Hoy, en el punto de venta que pruebo, es plata, stock y comprobante: lo que si sale mal se ve en la caja o en un papel que alguien se lleva. En otro producto la lista es otra, y en éste dentro de un año también puede serlo. Lo que no cambia son los dos ejes.
La celda de abajo a la izquierda es la que cuesta respetar. Generar ese caso es gratis y la sensación de cobertura es agradable. Pero ese test va a correr todos los días durante dos años, y no va a encontrar nada.
Qué técnica, y por qué ésa
Elegida la profundidad, la técnica sale de la forma del problema, no del gusto.
Hay rangos —montos, cantidades, porcentajes— entonces partición de equivalencias y valores límite. Un caso por clase y los bordes exactos.
El resultado depende de varias condiciones a la vez, entonces tabla de decisión. Es la única forma de ver cuáles combinaciones nadie está probando.
El objeto cambia de estado —se emite, se confirma, se anula— entonces transición de estados. Ida y vuelta: lo que casi nunca se prueba es deshacer, y ahí es donde suele estar el bug.
La misma regla existe en web y en mobile, entonces una de las dos es el oráculo de la otra. Si dan distinto, una está mal y da igual cuál.
Error guessing, sí, pero con una condición: cada caso adivinado viene con el bug que lo motivó. Si no puedo nombrar el defecto que me hizo pensar en eso, es un caso decorativo.
Y las heurísticas que sólo existen en mobile, que no salen de ninguna técnica de libro: el botón atrás a mitad de una operación, la app mandada a segundo plano y traída de vuelta, la red que se corta justo al confirmar, el doble tap sobre el botón que ya respondió, el teclado numérico que no deja escribir lo que la validación espera.
Un dato sirve si discrimina
Esto es lo que más me cambió la forma de armar casos, y no tiene nada que ver con la IA.
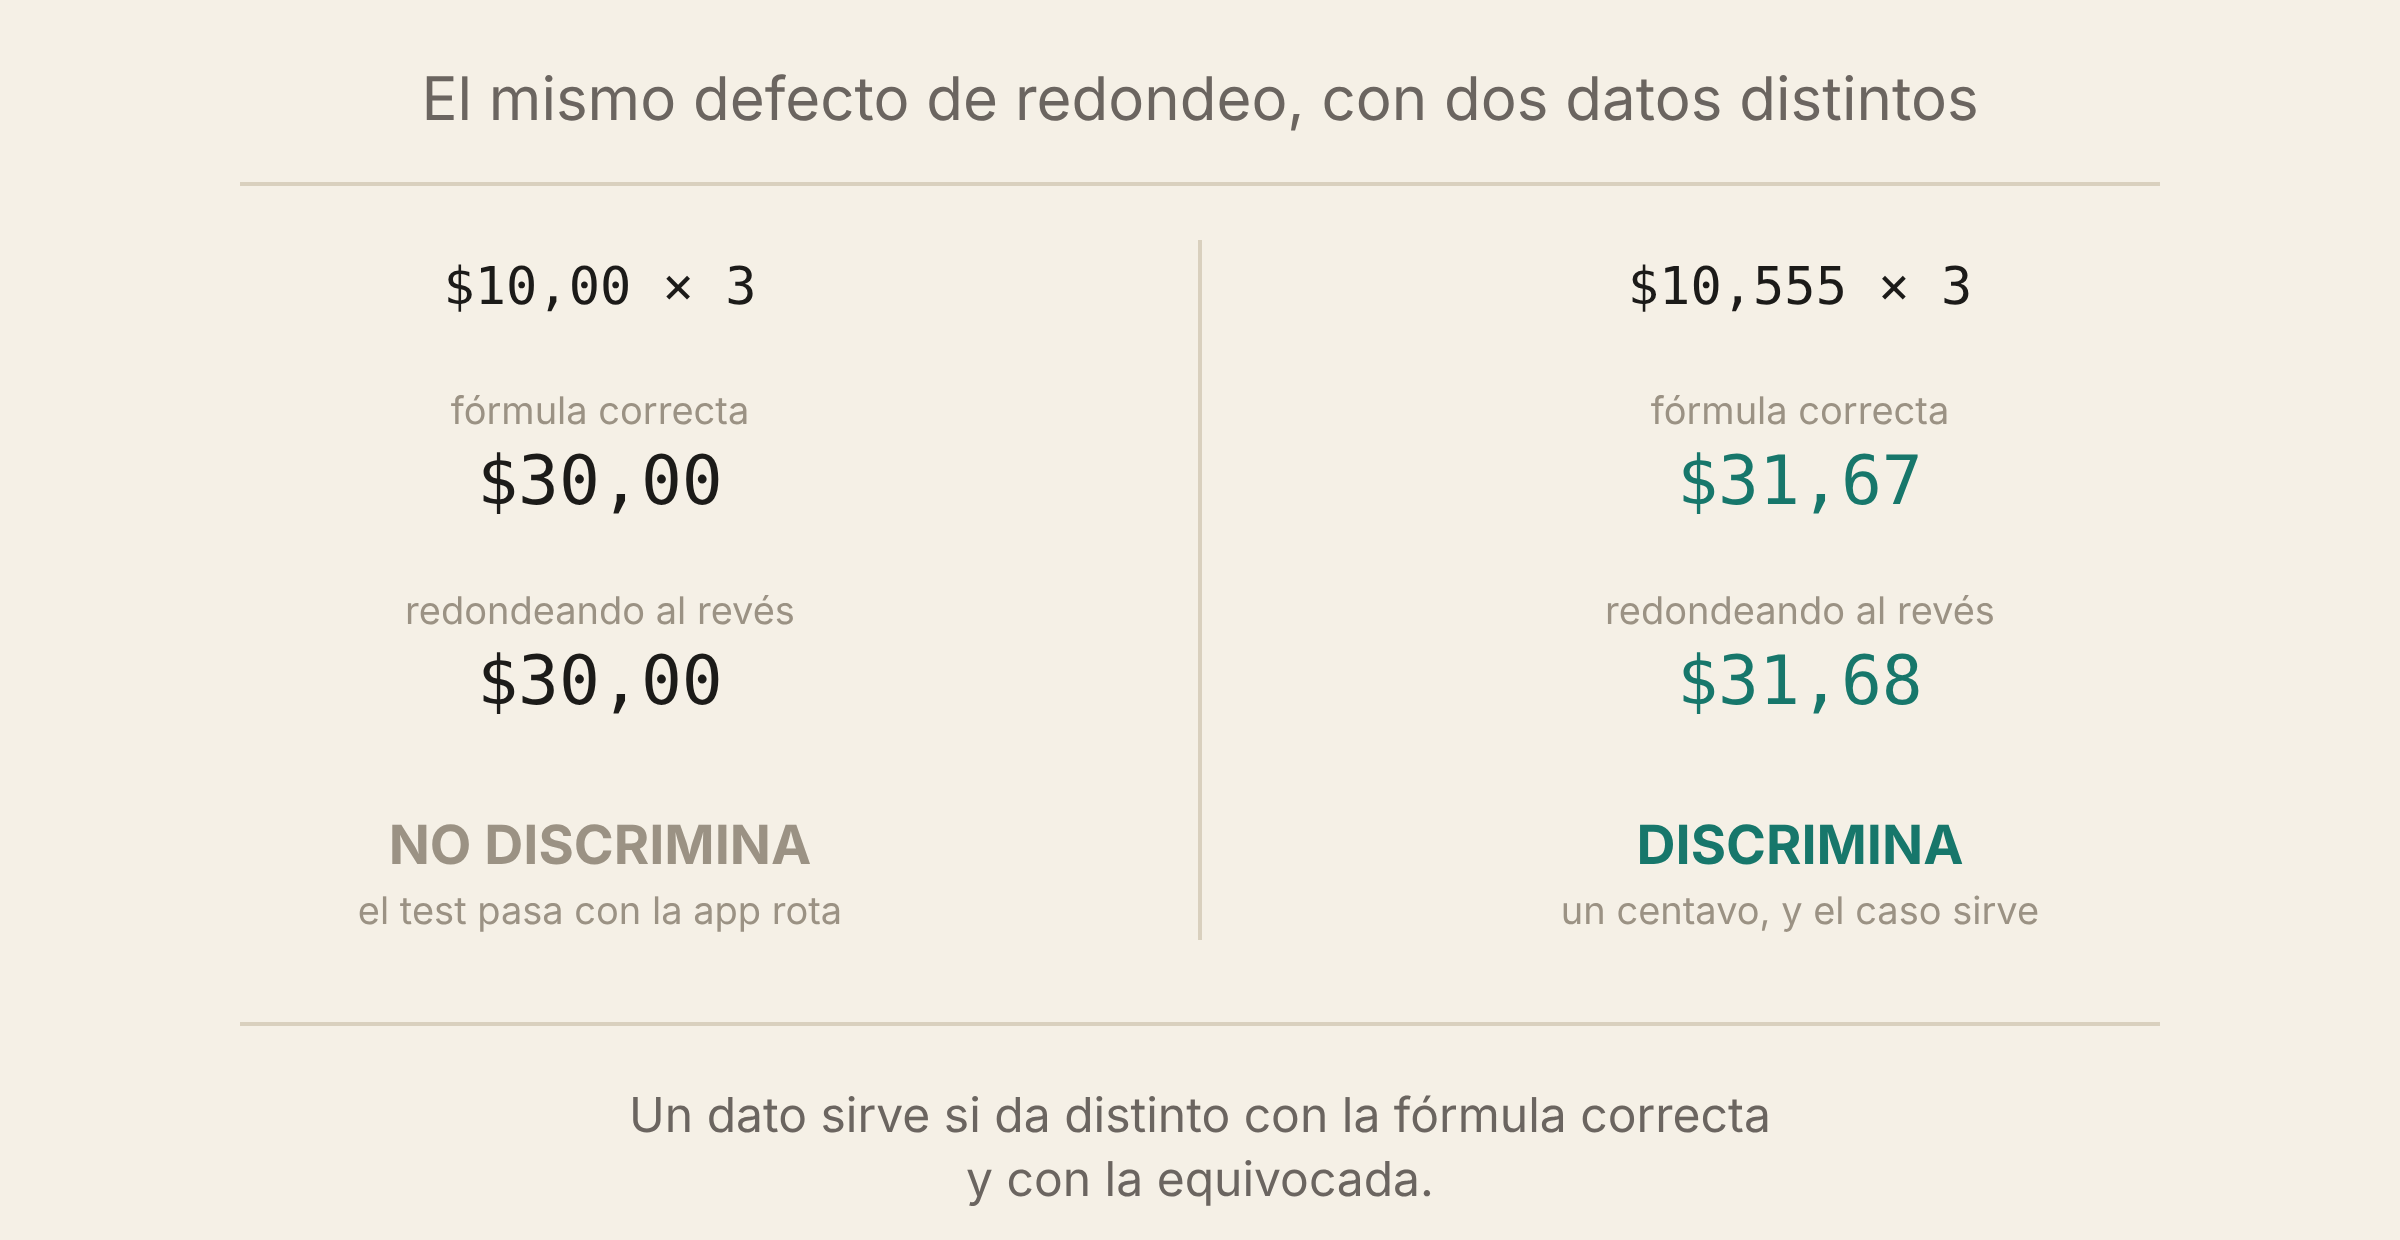
Un dato de prueba no sirve porque sea realista. Sirve si da distinto con la fórmula correcta que con las maneras en que la app podría estar mal: sin el impuesto, con el descuento aplicado dos veces, con el redondeo al revés.
_Error: elegí un artículo de $10,00 para validar el total de una línea, cantidad 3. Esperado $30,00, leído $30,00, verde. Pero el defecto que ese caso tenía que atrapar era de redondeo —redondear el precio unitario antes de multiplicar, en vez de después— y con un unitario de dos decimales exactos las dos fórmulas dan el mismo número. El test hubiera pasado igual con la app rota de esa manera exacta.
Con un unitario de $10,555 y la misma cantidad, el camino correcto da $31,67 y el defectuoso $31,68. Un centavo. Ahí el caso empieza a servir.
_Aprendizaje: un dato que no discrimina es un verde que no valida nada.
Desde entonces, elegir el dato es parte del diseño del caso, no un trámite previo a escribirlo.
Dónde mirar, que no es donde uno mira
Dos cosas que agrego a cada plan y que no salen de ninguna técnica.
Todas las superficies. Una regla de cálculo se valida en cada pantalla que la muestra, con código propio en cada una. Cargar y editar son dos superficies distintas: ya hubo defectos que estaban en una y no en la otra. Validar una sola y suponer la otra es exactamente el atajo que después se paga.
Terminar la operación y comprobar lo guardado. El test no termina cuando aparece el número de comprobante. Entra a ver lo que quedó registrado, y adentro del detalle, al detalle. Lo que la pantalla de confirmación muestra y lo que la base guardó no siempre son la misma cosa.
La skill no escribe tests, escribe el plan
Todo esto está en una skill que corre antes que los agentes. Y lo que produce no es código: es un informe para que yo lo revise. Qué casos propone, con qué técnica, con qué datos, y por qué esa profundidad y no otra.
Esa frontera es a propósito. Si la skill escribiera los tests directamente, el criterio quedaría adentro de algo que nadie lee. Separado, tengo un documento corto que puedo discutir, podar y rechazar antes de que exista una línea.
Y el plan baja con dos reglas escritas para quien lo implemente, que son las que más me importan:
- Si el test falla, no se ajusta el esperado. Se averigua por qué falla.
- Cada test nuevo se ve fallar una vez a propósito antes de dejarlo verde.
La primera existe porque ajustar el esperado es la salida más rápida y la más cara. La segunda, porque un test que nunca se vio en rojo no se sabe si puede ponerse en rojo.
Lo que esto no resuelve
- La matriz la lleno yo. Si valoro mal el riesgo de una funcionalidad, todo lo que viene después está prolijamente mal.
- Podar casos es una decisión sin evidencia: no hay forma de medir el bug que no encontré porque decidí no escribir ese test.
- El criterio de qué es impacto alto es de mi dominio. En otro producto la tabla es otra.
Lo que aprendí
Las técnicas de diseño de pruebas se enseñan en el primer curso de testing y después se usan a medias, porque escribir casos era caro y uno terminaba haciendo los que podía, no los que correspondían.
Ahora escribir es barato y el cuello de botella se mudó: lo escaso es el criterio para decidir qué no escribir. Resulta que para eso servían.
Próximo paso
Medir cuántos de los casos que podé hubieran encontrado algo. Todavía no sé cómo.
¿Te sirvió o querés discutirlo? Escribime →