Tres caminos por los que un agente me degradó el repo
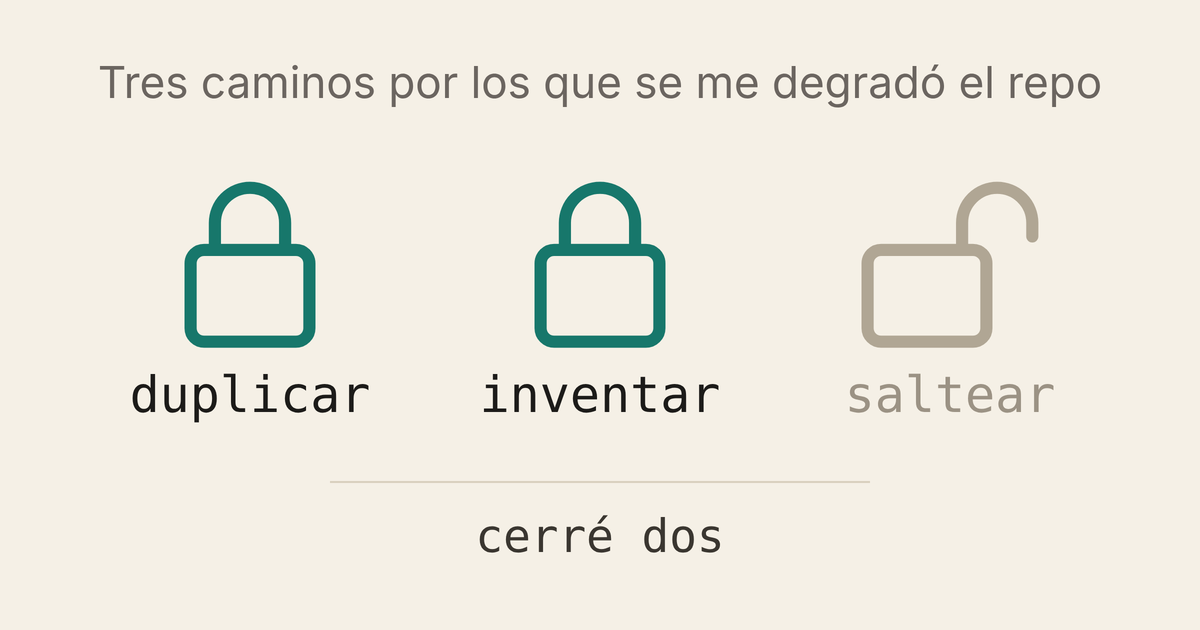
Duplicar, inventar y saltear: los tres por los que vi degradarse el repo. Cerré dos con arquitectura y gates; el tercero sigue abierto.
No leo línea por línea el código que escriben los agentes. No puedo: escriben más rápido de lo que leo. Pero tampoco es una caja negra — controlo la arquitectura, el plan y el resultado. Lo que cambió es el nivel al que miro.
Y lo que hace que eso alcance es una decisión del repo que no tiene nada que ver con la IA: un caso nuevo es agregar datos, no código. El spec carga un JSON, llama a un flujo que ya existe y verifica. El código de abajo ya está escrito.
Cuando un caso nuevo es un JSON, casi no hay superficie donde equivocarse.
En lo que llevo trabajando así, un agente me degradó el repo por tres caminos: duplicar, inventar y saltear. Puede que haya más; éstos son los que vi. Este post es cómo cerré dos, y por qué el tercero sigue abierto.
Qué controlo, concretamente
Antes de los tres caminos, conviene que quede claro qué miro, porque "no reviso el código" suena peor de lo que es.
| Sí | No |
|---|---|
| El plan: qué casos entran y por qué | Cada línea de cada spec |
| La propuesta, antes de que escriba | El diff completo de cada cambio |
| La arquitectura: dónde va cada cosa | Si un método quedó dos líneas más largo |
| El resultado: auditor, mutación, reporte |
Es la diferencia entre revisar un PR y diseñar el repo donde ese PR va a caer. Lo segundo escala; lo primero no.
Una aclaración de vocabulario, porque la palabra va a aparecer todo el tiempo de acá en adelante: un gate es un script que corre solo en un momento fijo —al guardar un archivo, antes de un commit, antes de lanzar un comando— y no deja seguir si no se cumple una condición. No avisa: frena.
Y frena igual si el que se equivocó soy yo. No es una correa para la IA, es una regla del repo. Lo que cambió es que antes los errores llegaban de a uno y ahora llegan de a siete.
Camino 1 · Duplicar
Lo que hace un agente cuando no encuentra algo: lo escribe de nuevo. Y termina con tres métodos casi iguales que hacen casi lo mismo, que es la forma más rápida de volver un repo irreusable.
Dos cosas lo cierran.
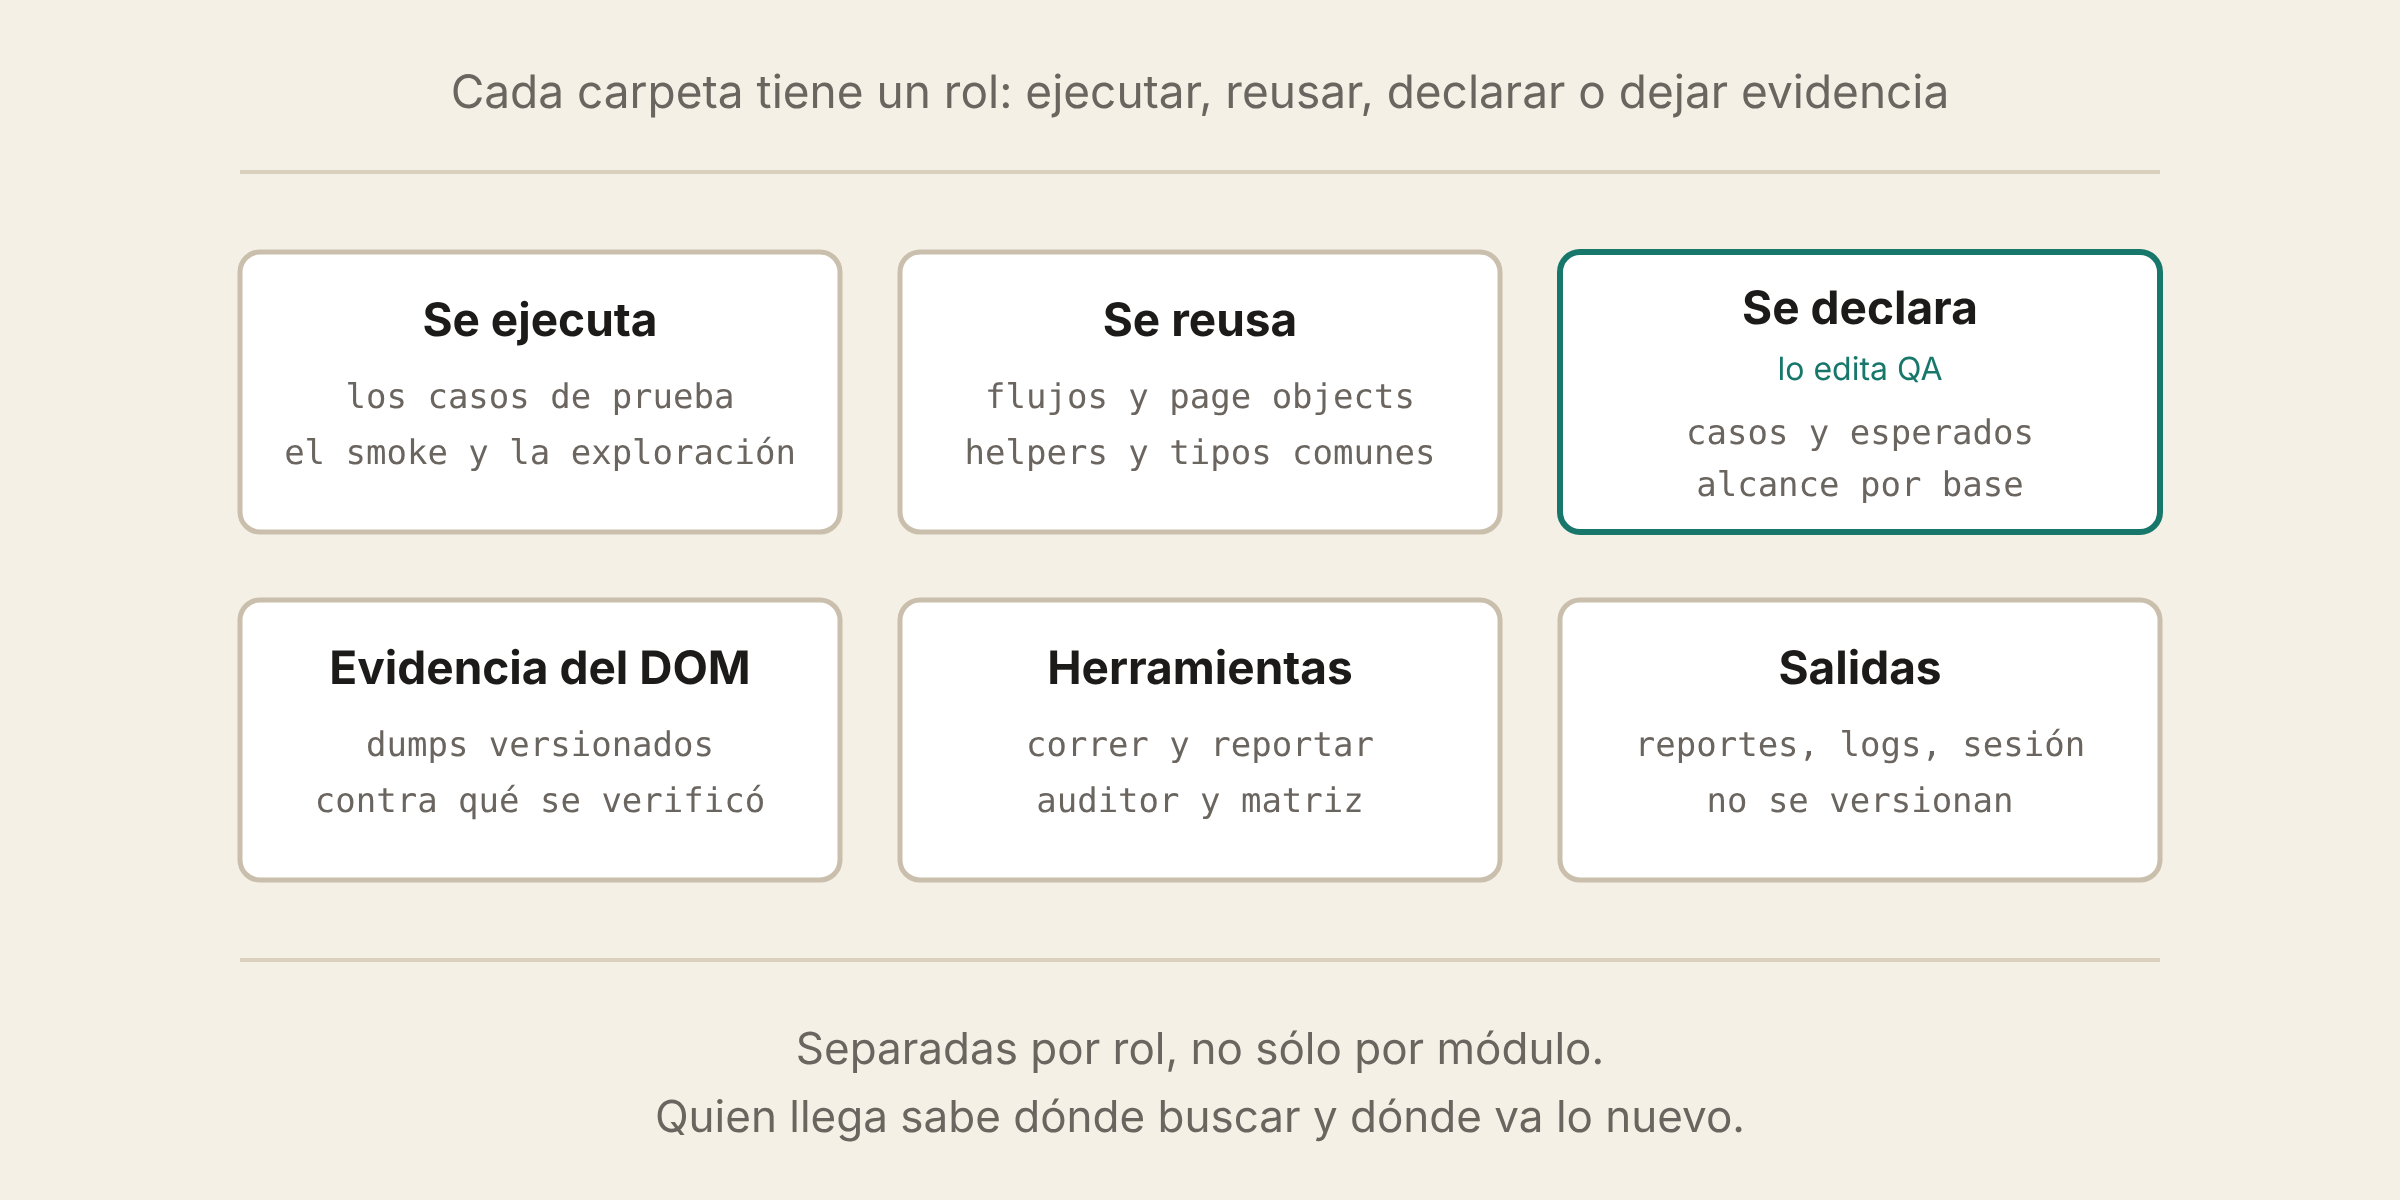
Un lugar para cada cosa. Las carpetas están separadas por rol, no sólo por módulo: lo que se ejecuta, lo que se reusa, lo que declara QA, la evidencia del DOM, las herramientas y las salidas que no se versionan. Quien llega —persona o agente— sabe dónde buscar y dónde va lo nuevo sin preguntar.
El inventario de métodos, congelado. Hay un listado de todos los métodos públicos del repo, y agregar uno rompe el gate salvo que escribas por qué. Hoy son más de 200.
Eso no prohíbe crecer. Obliga a justificar el crecimiento, que es distinto: frena justo lo que un agente haría por defecto, que es agregar un método nuevo en vez de buscar el que ya está.
Camino 2 · Inventar
Un agente que no tiene el dato lo completa. Es su naturaleza. Así que hay que no dejarle huecos.
Los selectores no se escriben de memoria. Viven en un mapa tipado, uno por pantalla, y cada uno está anotado con el dump del DOM contra el que se verificó. Esos dumps están versionados en el repo: son la prueba de que el selector existió alguna vez de verdad. Un selector suelto en medio de un spec lo marca el auditor.
Los esperados no se escriben en el código. Van al JSON del caso, con su origen y su cálculo. Un esperado hardcodeado rompe el commit.
El compilador revisa antes que yo. TypeScript estricto e interfaces para los datos de cada caso. Un dato mal armado no llega al device: lo corta el compilador, en segundos, sin gastar una corrida.
De los tres caminos, éste es el que quedó mejor cerrado. No porque yo sea especialmente riguroso, sino porque es el único que se puede verificar con un script.
Camino 3 · Saltear
Éste es el que no cerré.
Saltear es omitir un paso de una secuencia que ya existe. El flujo para emitir una nota de crédito tiene cuatro pasos; un agente mira el tercero —cargar las cantidades— y razona bien: si la anulación es total se devuelve todo igual, ese paso sobra. Lo saltea, y el test falla, porque sin cargar las cantidades no se habilita la pantalla siguiente. Estaba escrito en el comentario del método, dos líneas más arriba.
_Error: en un solo día perdí cuatro corridas así, todas sobre la misma tarjeta. Lanzar la suite, esperar lo que tarda, y que al final los rojos sean míos. Cuatro veces un paso salteado, y cuatro veces el aviso estaba escrito al lado.
_Aprendizaje: tener la regla escrita no es tener la regla.
De las ocho reglas de mi estándar, siete tienen un script que las hace cumplir. Reusar incluye leer es la única que no, y es la que más se rompe. Tampoco veo cómo gatearla: un script no puede distinguir un paso que correspondía saltear de uno que hacía falta, porque para eso hay que saber por qué existe.
Si un error se puede frenar con un script, se frena. Si depende de que alguien lea, se repite.
La misma estructura, para los dos
Ninguna de estas decisiones es para la IA. Son las mismas que le sirven a una persona, sólo que el beneficio se lee distinto.
| Decisión | A una persona que programa | A una IA que programa |
|---|---|---|
| Un lugar para cada cosa, por rol y módulo | encuentra lo que busca sin preguntar | busca donde corresponde antes de escribir, y no duplica |
| El spec es datos + flujo + verificar | se lee como el escenario de negocio | el caso nuevo es un JSON: casi no hay código donde equivocarse |
| Selectores en un mapa, contra un dump versionado | si la app cambia un atributo, se corrige en una línea | no los inventa: los contrasta con el DOM real guardado |
| Docstrings con la fecha y el caso que originó cada paso | entiende por qué existe un paso que parece de más | no "optimiza" un paso que ya costó una corrida |
| Gates sobre métodos, esperados y selectores | no depende de que alguien revise cada PR | frena justo lo que haría por defecto |
| TypeScript estricto e interfaces | errores en el editor | lo corrige el compilador antes de llegar al device |
Cuando ordené el repo no estaba pensando en agentes. La tercera columna no fue un objetivo de diseño: me la encontré después.
Lo que mide el resultado
La estructura evita que se degrade. Falta comprobar que lo que sale sirve, y eso son tres cosas.
El auditor, con trinquete. Diecisiete reglas que corren antes de cada commit. No piden que el repo esté perfecto: guardan cuántos problemas hay de cada regla y fallan si alguno sube. Una regla en cero queda cerrada; una en cuarenta no puede llegar a cuarenta y uno; bajar siempre se puede. Arreglar no alcanza: hay que impedir la regresión. Las excepciones van a un archivo con su motivo escrito, y el auditor las lista siempre.
Un subagente adversarial que revisa cada propuesta antes que yo, con una sola pregunta: qué error real de plata, comprobante o stock pasaría sin que ninguno de esos tests se ponga rojo. Y una regla que lo vuelve útil en vez de ruidoso: cada hallazgo tiene que venir con su escenario — "si la app hiciera X, el caso Y daría verde igual". Si no podés escribir esa frase, no es un hallazgo.
La prueba de mutación, que corre el agente al terminar y que conté acá.
Lo que esto no resuelve
- La estructura frena el código que empeora, no el plan equivocado. Si el caso no había que escribirlo, el gate lo deja pasar prolijo.
- El camino de saltear sigue abierto y no tengo idea de cómo cerrarlo.
- La deuda que el trinquete congeló sigue ahí. No crece, pero tampoco baja sola.
Lo que aprendí
Pensaba que trabajar con agentes iba a pedirme herramientas nuevas. Me pidió ordenar lo que ya tenía.
Page Object Model, datos fuera del código, un lugar para cada cosa, comentarios que explican por qué existe un paso: nada de eso es nuevo y nada de eso lo inventé yo. Son buenas prácticas de hace veinte años que uno aplica a medias porque el repo igual funciona.
Con agentes dejan de ser opcionales. Un repo desordenado con una persona es incómodo. Un repo desordenado con siete agentes se degrada solo.
¿Te sirvió o querés discutirlo? Escribime →